从一个疑问说起:只有一串哈希,文件是怎么“完整还原”的?
很多第一次接触磁力链接的人都会好奇:它不像种子文件(.torrent)那样自带一份完整的清单,通常只给出一串几十位长的十六进制哈希,为什么最终却能把一个几 GB 的文件一点不差地下载下来?这背后的关键,正是 bt磁力 与 BT 协议里的分块(piece)机制与哈希校验。理解这套原理,也有助于你在使用磁力搜索、磁力搜索引擎时更理性地判断一份种子资源是否可靠。
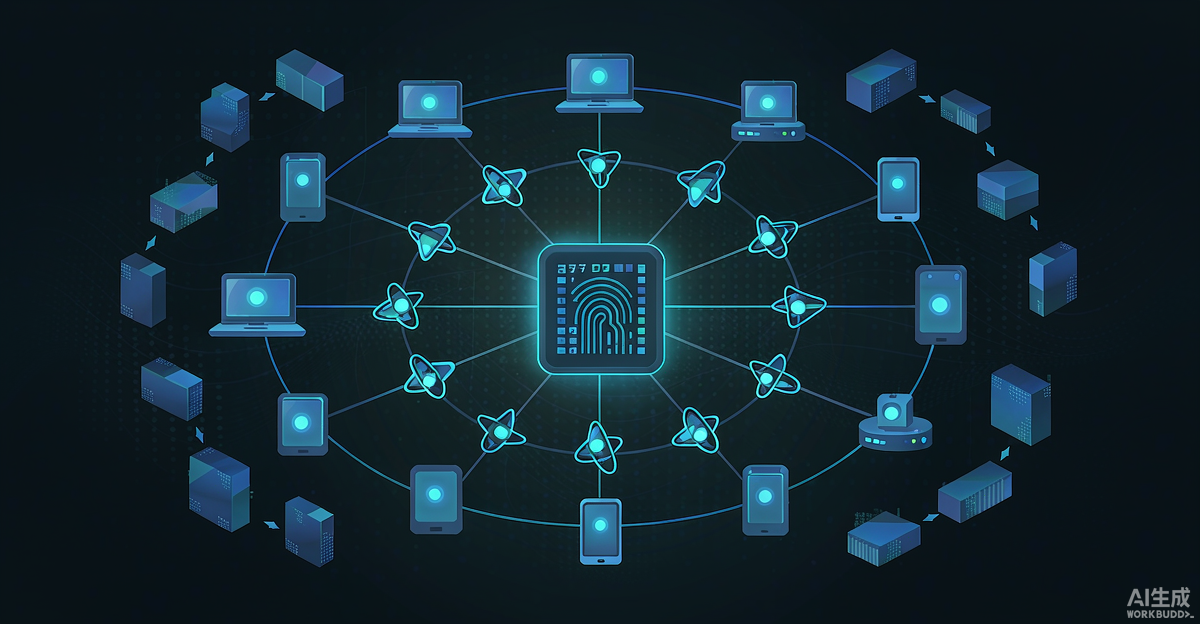
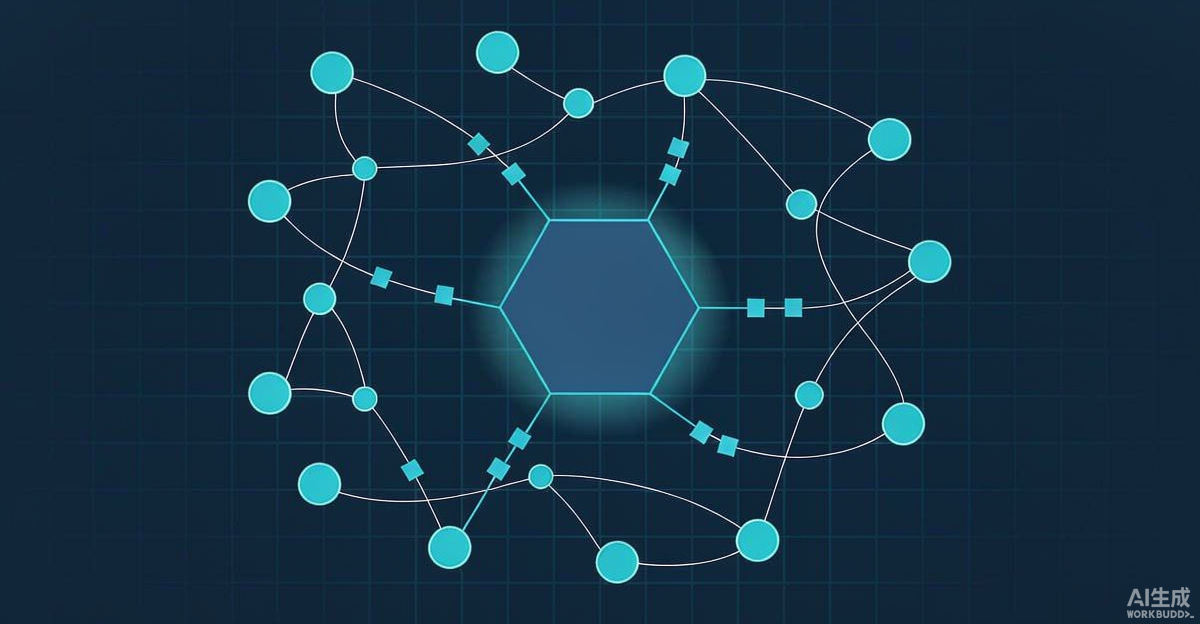
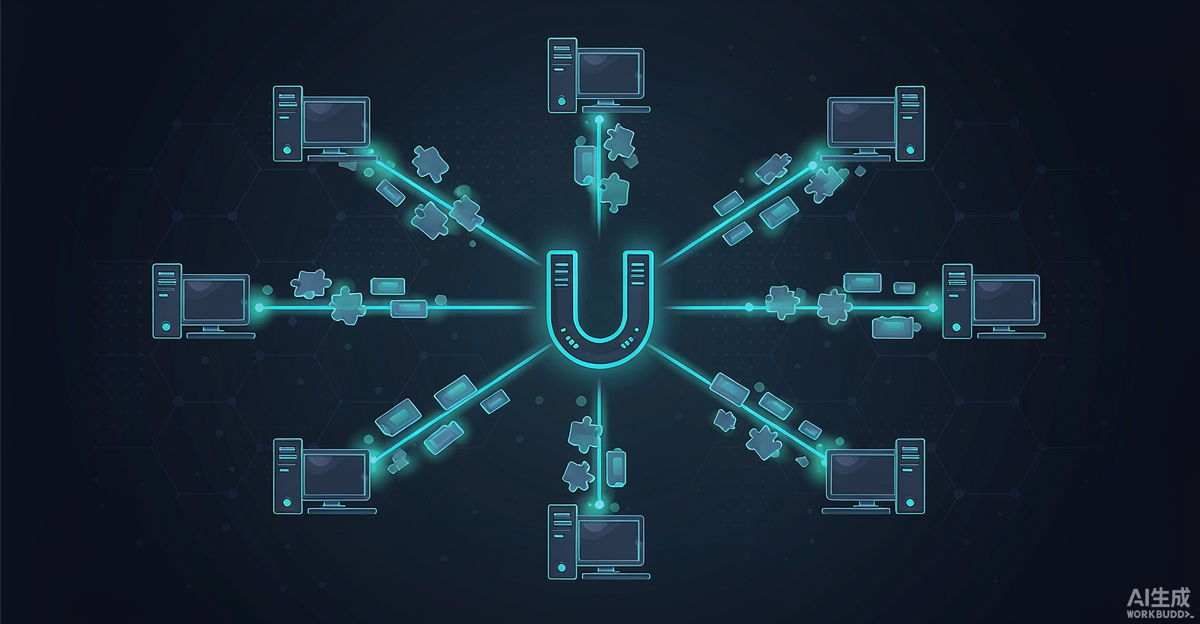
简单说,BT 协议并不是把一个大文件当作一整块来传输,而是先把它切成许多固定大小的“分块”,每一个分块都单独计算一个哈希值。当这些哈希被汇总、再经过层层计算,就得到了那个唯一的 InfoHash,也就是磁力链接里最核心的标识。下载时,客户端从不同对等节点(Peer)分别拉取不同的分块,再逐一校验、拼回原位,最终还原出完整文件。
分块是怎么被“切开”的?
一份种子资源在制作时,软件会按照一定规则把内容切成若干分块,常见的大小从 256 KB 到几 MB 不等。切分规则并非随意:文件越大,分块数量越多;每个分块的边界是固定的,这样任何客户端只要拿到同一份元数据,就能切出完全一致的块。
分块大小影响什么
分块太大,单块传输失败后重传的成本高;分块太小,哈希校验的开销和元数据体积又会上升。因此做种工具通常会在效率与开销之间取一个平衡值。对下载者而言,分块数量决定了“下载进度条”的颗粒度——你会看到客户端一格一格地亮起,每一格大致就对应若干个分块的完成。
哈希校验:保证“拼回去还是原来的文件”
光有分块还不够,还需要一种机制来确认每一块都没有传错。BT 的做法是给每个分块单独算一个哈希(通常用 SHA-1 或更安全的算法),下载客户端每拿到一个分块,就会重新计算它的哈希并与元数据里记录的值比对。一致则保留,不一致则丢弃并重新向其他节点索取。
这种“边下边验”的设计,正是 P2P 下载能放心从互不认识的节点取数据的原因:你不需要信任任何一个对等节点,只需要信任那一串写死的哈希值。这也解释了为什么磁力搜索的结果里,同一个资源名往往对应不同的哈希——内容哪怕只改了一个字节,InfoHash 也会完全不同,这也是内容寻址的天然“去重”特性。
校验通过后才算“完整”
当所有分块都校验通过后,客户端会再做一次整体校验,确认文件的最终哈希与预期一致,此时才算“完成”。这也是为什么下载到 99% 会卡住一段时间——很可能只是最后一两个分块还没找到健康的来源,而不是文件坏了。
磁力搜索引擎在其中扮演什么角色?
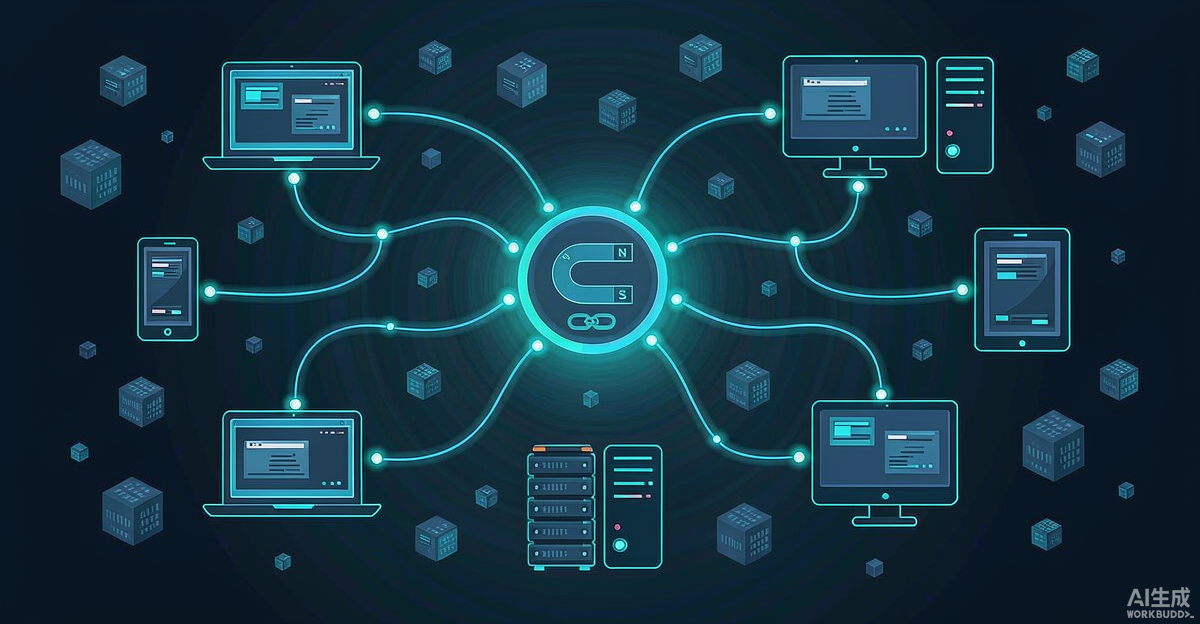
磁力搜索引擎并不保存文件本身,它更像一本“哈希黄页”,负责记录某个 InfoHash 对应的名称、体积、做种数等信息。当你通过磁力搜索找到一个条目时,真正发挥作用的是这串哈希:客户端用它去 DHT 网络或 Tracker 里寻找持有对应分块的对等节点,再由节点之间互相补全缺块。
这意味着,只要哈希还在、全网仍有至少一个持有完整副本的做种者,文件就能被逐渐还原;反之,一旦做种者全部离线,这份种子资源就成了“死种”,再强的搜索引擎也无能为力。
合法用途与下载安全边界
分块重组与哈希校验本身是中性的技术,广泛应用于许多正当场景。大量开源项目与操作系统发行版都会在官方下载页提供 .torrent 或磁力链接,例如部分 Linux 发行版的镜像分发就借助 P2P 来降低服务器带宽压力,同时依靠哈希校验保证镜像完整、未被篡改。公有领域或采用宽松许可的内容,同样可以用这种方式高效共享。
需要提醒的是,哈希只能保证“内容完整”,并不能保证“内容安全”或“内容合法”。一个文件完全可以被校验通过,却携带恶意代码,或涉及受版权保护的影视、软件。因此下载前请认准官方渠道、核对官方公布的哈希,避免从来源不明的站点获取资源;涉及版权内容时,务必使用正版平台或取得授权的合法渠道。
小结
磁力链接与 bt磁力 之所以能在没有中心服务器的情况下可靠还原文件,靠的是“分块 + 哈希校验 + 对等节点补全”这套组合机制:文件被切成固定分块,每个分块用哈希锁定,客户端边下边验、拼回原位,最终还原出完整文件。磁力搜索引擎只是帮你定位哈希,真正决定成败的是全网做种者的健康度。理解这套原理后,你可以更安全、更理性地使用磁力搜索与种子资源——把它用在开源软件、Linux 镜像等合法分发上,同时保持版权意识,远离来源不明的侵权内容。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章
暂无评论...